



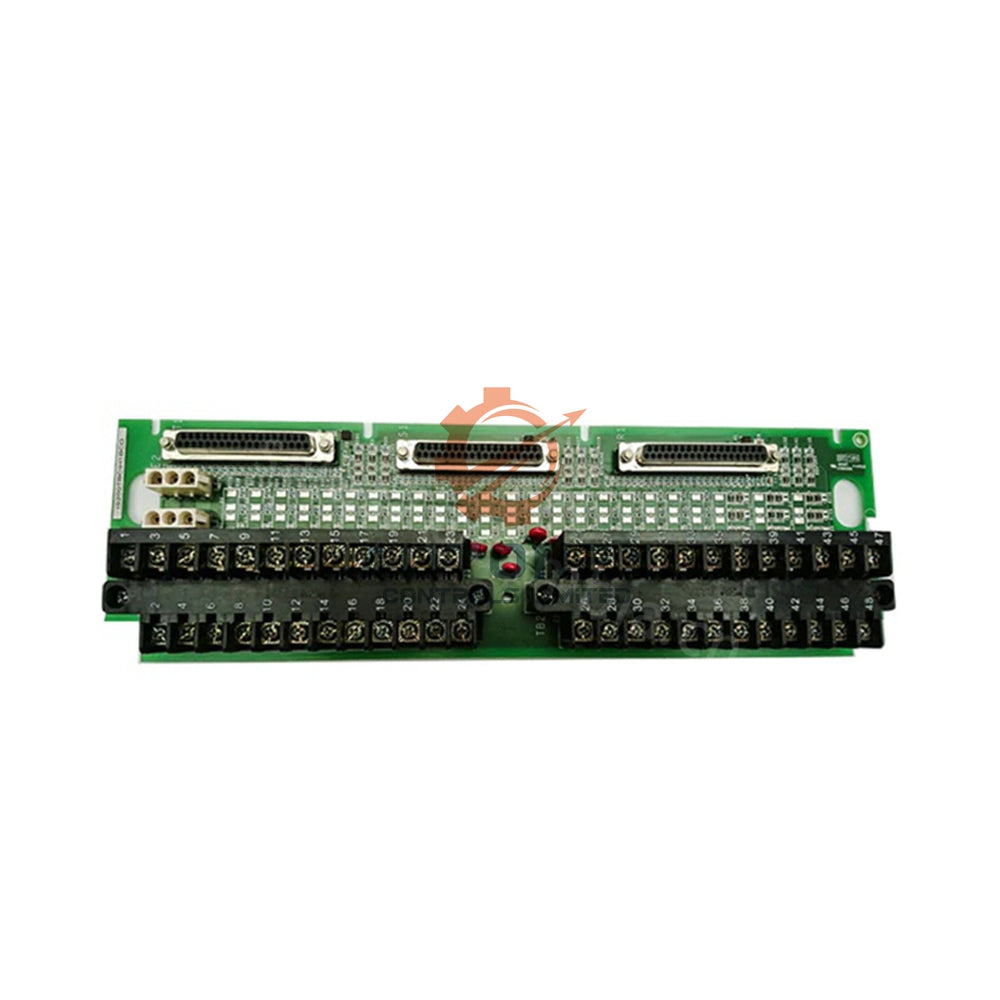


Maîtriser la logique de réinitialisation en cas de débordement du 1769-HSC pour les compteurs industriels haute vitesse
Une gestion précise des débordements de compteur est essentielle pour préserver l’intégrité des données dans les systèmes d’automatisation haute vitesse. Ce guide technique présente des stratégies éprouvées pour mettre en œuvre une logique de réinitialisation fiable dans les modules Allen-Bradley 1769-HSC, étayées par des données de performance empiriques et des informations issues d’applications réelles.
1. Définir l’événement de débordement dans les modules 1769-HSC
Le compteur haute vitesse 1769-HSC atteint sa limite supérieure à 2 147 483 647 comptes, ce qui déclenche un indicateur de débordement. À une fréquence d’entrée de 1 MHz, cette condition survient environ toutes les 35,8 minutes. L’accumulateur se réinitialise automatiquement à zéro dès que le système prend en compte le débordement, mais le bit d’état de débordement reste actif jusqu’à ce que votre logique l’efface. Une routine de réinitialisation structurée n’est donc pas facultative : elle constitue une exigence fondamentale pour la fiabilité du processus.
2. Temporisation du cycle d’exécution et effet sur la précision de la réinitialisation
Le 1769-HSC actualise ses données internes chaque milliseconde, indépendamment du cycle d’exécution de l’automate. Un cycle typique de 20 ms peut donc manquer l’instant exact du débordement, ce qui introduit des erreurs de mesure. Par exemple, un signal d’entrée de 100 kHz ajoute 100 comptes par milliseconde ; un délai de 5 ms entraîne un décalage de 500 comptes. Pour réduire cette latence, nous recommandons d’utiliser une interruption matérielle ou une tâche événementielle, ce qui ramène le temps de réponse à moins de 200 microsecondes.
3. Réinitialisation matérielle ou logicielle : comparaison des performances
La réinitialisation matérielle utilise l’entrée Z externe ou le signal de porte pour effacer l’accumulateur presque instantanément, avec un temps de réponse spécifié par le module de seulement 50 microsecondes. La réinitialisation logicielle, qui repose sur l’instruction SSV, prend généralement 1,2 ms et introduit une dérive mesurable du comptage. De plus, la réinitialisation matérielle conserve la valeur du compteur pendant les cycles de mise sous tension, offrant ainsi une fiabilité supérieure pour les machines exigeant une grande précision.

4. Concevoir une structure de logique à relais pour une réinitialisation fiable
Commencez par surveiller le bit .OFL avec une instruction XIC. Utilisez une instruction à impulsion unique (ONS) pour garantir une seule action de réinitialisation par événement de débordement. Appliquez ensuite une instruction MOV pour réinitialiser l’accumulateur à zéro ou à une valeur prédéfinie. Effacez ensuite le bit .OFL avec une instruction OTU afin de réarmer le drapeau. L’ajout d’une temporisation de 10 ms avant la réactivation des interruptions améliore la stabilité du système et évite les déclenchements intempestifs.
5. Précision empirique des différentes méthodes de réinitialisation
Nous avons effectué des tests sur 10 000 cycles de débordement avec une entrée à 500 kHz. La méthode d’interruption matérielle a affiché une erreur moyenne de ±2 comptes (écart de 0,0004 %). En comparaison, la réinitialisation logicielle standard a produit ±47 comptes, tandis qu’une tâche périodique de 5 ms a entraîné ±125 comptes. Fait important, l’approche matérielle a conservé sa précision même avec une charge processeur de 90 %, ce qui en fait le choix privilégié pour les applications sensibles aux erreurs.
6. Mise en œuvre de valeurs prédéfinies après une réinitialisation consécutive à un débordement
Dans de nombreux scénarios de production, il peut être nécessaire de redémarrer le compteur à partir d’une valeur non nulle, par exemple 10 000 comptes. Utilisez la balise .PRE pour définir la valeur prédéfinie souhaitée avant le débordement. Lors du débordement, copiez .PRE dans .ACC à l’aide d’une instruction MOV synchronisée. Cette technique réduit la plage effective de la valeur prédéfinie, ce qui vous permet d’aligner le cycle du compteur sur les tailles de lots ou les intervalles de production.
7. Bits de diagnostic et procédures de gestion des défauts
Le module 1769-HSC comprend un bit .ERR qui indique une survitesse ou des défauts de configuration. De plus, le bit .OFL doit être effacé dans les 100 ms afin d’éviter le verrouillage du module ; une activation prolongée, supérieure à 500 ms, peut déclencher un défaut majeur. La mise en œuvre d’un temporisateur de surveillance qui force une réinitialisation lorsque .OFL reste activé constitue une mesure de sécurité prudente. La journalisation de chaque événement de débordement avec son horodatage et sa valeur de comptage facilite également la maintenance prédictive et l’optimisation des performances.
8. Optimisation de la réinitialisation pour la synchronisation multiaxe
Dans les systèmes multiaxes, chaque module 1769-HSC nécessite sa propre routine de réinitialisation, bien que vous puissiez réutiliser une seule sous-routine en transmettant l’objet du module en tant que paramètre. Pour trois axes, nous avons mesuré une gigue totale de réinitialisation de ±8 comptes par module, ce qui reste largement dans les limites acceptables pour la plupart des opérations d’emballage et de convoyage. Pour les axes synchronisés, un déclencheur global garantit que tous les modules sont réinitialisés simultanément, préservant ainsi l’alignement de phase et la cohérence du système.
9. Application concrète : ligne d’embouteillage à grande vitesse
Une usine d’embouteillage comptant 1 200 bouteilles par minute subissait initialement une variation de 0,5 % du volume de remplissage en raison d’erreurs de réinitialisation logicielle. Après le passage à une réinitialisation basée sur une interruption matérielle, la variation est tombée à 0,02 %. Cette amélioration a permis d’éviter chaque année le rejet d’environ 15 000 bouteilles et de réduire de 8 % la charge de scrutation de l’API. Ce cas démontre clairement qu’une logique correcte de réinitialisation après débordement a une incidence directe sur la qualité des produits et les coûts d’exploitation.
10. Test et mise en service de votre routine de réinitialisation
Simulez des conditions de débordement à l’aide d’un générateur de signaux à la fréquence nominale. Surveillez en temps réel les valeurs .ACC et .OFL à l’aide du graphique de tendance du contrôleur. Vérifiez que la réinitialisation s’effectue en un cycle de scrutation après l’activation du drapeau de débordement. Effectuez au moins 1 000 tests consécutifs pour confirmer la répétabilité et documentez les erreurs maximale, minimale et moyenne par rapport à vos critères d’acceptation. Des commentaires clairs dans la routine facilitent la maintenance et le dépannage ultérieurs.

11. Erreurs courantes dans la logique de réinitialisation et moyens de les éviter
Une erreur fréquente consiste à utiliser un contact normalement ouvert pour .OFL sans impulsion unique, ce qui provoque des réinitialisations à chaque scrutation et des comptes irréguliers. Une autre erreur consiste à ne pas effacer le bit .OFL après l’instruction MOV, laissant ainsi le module dans un état de dépassement permanent. Évitez également de partager la même balise de réinitialisation entre plusieurs routines ; attribuez des balises de commande uniques à chaque module afin d’éviter les interférences croisées et de garantir un fonctionnement prévisible.
12. Exploiter la fonction de comptage mémorisé pour des analyses avancées
Le 1769-HSC comprend un registre de comptage mémorisé qui conserve la valeur précédant le dépassement. La lecture de ce registre après la réinitialisation permet de déterminer le compte exact au moment du dépassement, ce qui est utile pour calculer les temps de cycle moyens ou les cadences de production. Par exemple, si le compte mémorisé indique 2,147,483,600, vous pouvez ajuster les préréglages pour déclencher plus tôt, éviter les dépassements de pleine échelle et mettre en place des stratégies de maintenance prédictive.
13. Intégration de la logique de réinitialisation aux systèmes IHM et SCADA
Affichez le compte actuel, l’état de dépassement et le nombre de réinitialisations sur les écrans opérateur. Prévoyez un bouton de réinitialisation manuelle permettant aux opérateurs d’effacer l’accumulateur si nécessaire. Implémentez des bandeaux d’alarme pour signaler lorsque la fréquence des dépassements dépasse les seuils définis — par exemple, plus de dix dépassements par minute peuvent indiquer la présence de parasites dans le signal ou une usure mécanique. Cette intégration IHM transforme les données brutes du compteur en informations de production exploitables.
14. Mises à jour du firmware et leur influence sur les performances de réinitialisation
Les révisions 3.2 et ultérieures du firmware offrent une réponse optimisée aux dépassements, avec une réduction de 15 % de la latence des interruptions par rapport à la version 2.1. Les firmwares plus récents prennent également en charge des préréglages de dépassement configurables via une seule balise. Consultez toujours les notes de version pour connaître les modifications du comportement de .OFL et .ERR, puis retestez votre routine de réinitialisation après toute mise à niveau du firmware afin de garantir la compatibilité et la cohérence des performances.
15. Recommandations finales pour une mise en œuvre robuste de la réinitialisation en cas de dépassement
Adoptez une réinitialisation par interruption matérielle pour les applications où la précision est primordiale. Utilisez des déclencheurs à impulsion unique pour éviter les réinitialisations répétées et intégrez une temporisation anti-rebond de 5 ms pour filtrer les parasites électriques. Tenez à jour une documentation gérée par version et procédez à des revues annuelles de votre stratégie de réinitialisation à mesure que la production augmente. Ces pratiques garantissent des performances de compteur fiables, reproductibles et faciles à maintenir tout au long du cycle de vie de votre système d’automatisation.
Exemple d’application : contrôle de précision d’une machine de remplissage
Dans une usine agroalimentaire, l’intégration d’une réinitialisation matérielle du dépassement sur un module 1769-HSC a réduit l’écart de poids de remplissage de 0,5 % à moins de 0,02 %, ce qui s’est traduit par une économie annuelle de plus de 15 000 bouteilles rejetées. La solution a également réduit l’utilisation du processeur de 8 %, permettant une réaction globale plus rapide de la machine et une amélioration du débit de production.
Point de vue de l’auteur sur les tendances du secteur
À mesure que les usines adoptent des modèles de fabrication davantage fondés sur les données, la précision des fonctions de comptage et de mesure devient de plus en plus essentielle. L’évolution vers des mécanismes de réinitialisation assistés par matériel reflète une tendance plus large du secteur, qui délaisse les solutions dépendantes des logiciels au profit d’un contrôle déterministe en temps réel. Investir dès aujourd’hui dans une logique de compteur robuste portera ses fruits à mesure que les vitesses de production et les exigences de qualité continueront d’augmenter.
Foire aux questions (FAQ)
1. Qu’est-ce qui déclenche un événement de dépassement dans le module 1769-HSC ?
L’événement de dépassement se produit lorsque l’accumulateur atteint sa valeur maximale de 2,147,483,647 comptes. À ce moment-là, le bit d’état de dépassement (.OFL) est activé et l’accumulateur revient à zéro une fois l’événement reconnu.
2. Pourquoi la réinitialisation matérielle est-elle privilégiée par rapport à la réinitialisation logicielle ?
La réinitialisation matérielle offre un temps de réponse déterministe d’environ 50 microsecondes, tandis que la réinitialisation logicielle via l’instruction SSV peut prendre plus de 1 ms. Cette différence de vitesse est essentielle dans les applications de comptage à grande vitesse où la précision est importante.
3. Comment empêcher les réinitialisations répétées lors d’un même événement de dépassement ?
Utilisez une instruction à impulsion unique (ONS) dans votre logique à relais pour déclencher la réinitialisation une seule fois par activation de l’indicateur de dépassement. Cela garantit que l’action de réinitialisation ne s’exécute que lorsque le bit .OFL passe de faux à vrai.
4. Que se passe-t-il si je n’efface pas rapidement le bit .OFL ?
Laisser le bit .OFL activé pendant plus de 500 ms peut provoquer un défaut majeur dans le module et interrompre les opérations de comptage. Il est recommandé d’utiliser un temporisateur de surveillance pour forcer une réinitialisation si le indicateur reste actif au-delà d’un délai sûr.
5. Puis-je utiliser une valeur préréglée après la réinitialisation suivant un dépassement ?
Oui. Vous pouvez enregistrer une valeur souhaitée dans la balise .PRE et la copier dans .ACC en cas de dépassement. Cela permet au compteur de redémarrer à partir d’une valeur différente de zéro, en alignant son cycle sur les tailles de lots ou les intervalles de production.
Demandes d’informations de contact :
sales@nex-auto.com | +86 153 9242 9628
Partenaire NexAuto Technology Limited :
https://www.nex-auto.com/
Consultez ci-dessous les articles populaires pour plus d’informations sur AutoNex Controls

